一份样本包含许多个体结果,频数表把它们汇集为各类的人数,比例则把这些人数与一个参照人群联系起来。同一个计数可以除以组内人数,也可以除以全体人数,所得数值便具有不同含义。描述统计研究的正是怎样用较少的数值和图形保留样本的分布与构成关系。
数据类型、分析单位与研究设计 决定了哪些结果可以合并、合并后的数值代表谁。以下从类别的频数展开,借两组成功结果讨论分母与权重,再考察位置、离散程度和图形表示。这里描述的均为已经取得的观测;样本到总体的推断还涉及抽样波动。
频数与相对频数
假设 100 位参与者中,渠道 search 有 50 人,social 有 30 人,referral 有 20 人。这些人数称为频数,分别除以 100,得到相对频数 50%、30%、20%。如果三类互斥且穷尽,每位参与者恰好被计入一次,因此计数合计为 100,比例合计为 100%;最终显示的小数可能因舍入而略有差异。
互斥表示一个人只归入一个类别,穷尽表示全部对象都属于列出的类别。两项条件决定了各格计数是否恰好划分全体。多选问卷允许同一人属于多个选项,选项人数之和便可能超过参与人数;以答题人数为分母的比例之和也可能超过 100%。此时“分母为答题人数,可多选”表达了实际的计数关系;强行把总和改为 100%,反而会更换统计对象。
渠道缺失时,两种比例分别对应不同人群:以所有参与者为分母,可以把缺失作为一种观测状态列出;以渠道已知者为分母,则描述已知者的类别构成,并另行给出缺失人数。“已知者中占 50%”与“全部参与者中占 50%”因此是不同命题,差别仍来自分母。
列联表中的条件比例与联合比例
考虑虚构实验中 400 位独立参与者的结果。他们随机分为两组,每组 200 人。把组别作为行、成功与未成功作为列,可得如下列联表;每一格记录同时属于某组、又具有某个结果的人数。
| 组别 | 成功 | 未成功 | 合计 |
|---|---|---|---|
| 对照 | 40 | 160 | 200 |
| 干预 | 70 | 130 | 200 |
| 合计 | 110 | 290 | 400 |
行内人数满足 、,行、列两种方向的汇总都回到同一批对象。成功人数既可与本组人数比较,也可与全部成功者或全部参与者比较,这产生了几种不同的比例:
- 对照组内的成功比例:。
- 干预组内的成功比例:。
- 所有成功者中干预组所占比例:。
- 全部参与者中既属干预组又成功的比例:。
后三项的分子都为 70,35% 描述干预组中的成功构成,63.6% 描述成功者中的组别构成,17.5% 则描述全体中“干预且成功”这一组合的构成。组内比例以一个已经给定的条件限定范围,联合比例以全体为范围;条件概率、独立与贝叶斯 将这种结构写成一般概率关系。
在这份虚构样本中,干预组与对照组的成功率之差为 15 个百分点,两个观测比例分别是 35% 与 20%。这是对样本的完整描述。总体中的差异还受抽样机制及其不确定性约束,因而样本描述与效应推断是两个相联系的层次。
合并比例及其权重
两组人数相等时,合并比例为 ,恰好等于两个组比例的算术平均。这种相等来自每组贡献相同数量的参与者。若 A 组 10 人中 8 人成功,B 组 90 人中 18 人成功,全体成功人数与全体人数之比则是
若计算 ,得到的是两个组成功率的平均,每组都占同样权重。全体参与者中的比例却让人数较大的组贡献更多信息。一个量以组为单位平均,另一个以人作分母,二者因平均对象不同而得到不同结果。
一般地,第 组包含 人,组内成功率为 ,两者的乘积恢复该组成功人数。先汇总各组成功人数,再除以全部人数,便有
人数权重把每个个体赋予相同贡献,所得比例描述全体参与者。若两组内部的年龄或渠道构成不同,各自使用的权重也会不同,整体与分层比较甚至可能反向,见 配对、分层与辛普森悖论。汇总结果由组内率与人群构成共同决定。
分类变量的分布摘要
对名义类别,频数最多的类别称为众数。渠道例子的众数是 search,它只指出最多的一类,未表达其余一半参与者怎样分布。频数表保留所有类别的构成,因而通常比单个中心类别提供更多信息。
有序变量的顺序使中位等级和累计比例有了定义。设 20 人的满意度为差 2 人、一般 6 人、好 8 人、很好 4 人,按等级排列后的累积人数为 2、8、16、20。第 10 与第 11 位均属于“好”,所以中位等级为“好”。若两个中间观测落在不同等级,给代码取平均可能产生一个测量中不存在的“2.5 等级”;报告两个中间等级或采用明确的中位数定义,才保留了顺序所提供的信息。
在同一分布中,“好及以上”占 ,“一般及以下”占 。阈值把相邻等级组成一个事件,计算只依赖先后顺序,并未假定等级间距相等。阈值由研究问题给定时,比例具有确定含义;观察多个切点后只保留最突出的结果,则会把选择过程带入分析。
编码的数量解释也决定了均值的意义。名义类别 1、2、3 的均值会随代码排列改变;二元结果用 0、1 表示,均值等于 1 的比例,因为总和就是该类人数。对于单个满意度等级,均值的解释额外依赖等级间距可以视为相等的假设,这项测量假设并不由计算程序给出。
数值变量的位置与离散程度
类别结果的解释变量常包含年龄和访问次数,因而数值分布也是分析的一部分。数值观测既有位置,也有彼此之间的距离。均值把总量分摊到每个观测,中位数则由排序后的中间位置决定,两者保留分布的不同特征。
五人的等待时间为 2、3、4、5、36 分钟,均值为 分钟,中位数为 4 分钟。36 这一较大观测拉高了总量与均值,而居中的位置仍在较短等待处。若关注典型个体的体验,中位数提供相应位置;若关注总耗时或每人的平均资源占用,均值仍是自然的量。
最小值与最大值确定全样本的范围,却只依赖两个极端观测。四分位数描述内部位置:第 25 百分位数为 ,第 75 百分位数为 ,四分位距 是中间一半数据的跨度。有限样本中的分位数还涉及相邻排序值如何插值,不同定义会产生微小差别;这种差别来自摘要规则,而非原始数据改变。
标准差衡量观测围绕均值的离散程度,单位与原变量相同。它描述个体数值的分散,既不是均值估计的误差,也不保证每个值都落在某个范围。均值的标准误描述的是均值在重复抽样中的波动,见 统计量与抽样分布。位置、离散程度与分布形状合起来,才表达数值样本的主要特征。
数据分布的图形表示
条形图以类别为轴、以条长表示计数或比例,各类别之间通常留有空隙。名义类别可以按研究顺序或频数排列,有序类别则依其等级排列。计数条长比较人数,比例条长比较组内构成;图形外观相似,但二者的参照尺度不同。
两组成功率可以用并列比例条形图或点图比较,共同的比例轴使差异直接可见,组人数与成功人数则说明比例来自多少观测。100% 堆叠条形图把每组的各类比例拼成完整构成;除了第一段,其余段通常没有共同起点,因此细小差异比点图或并列图更难辨认。
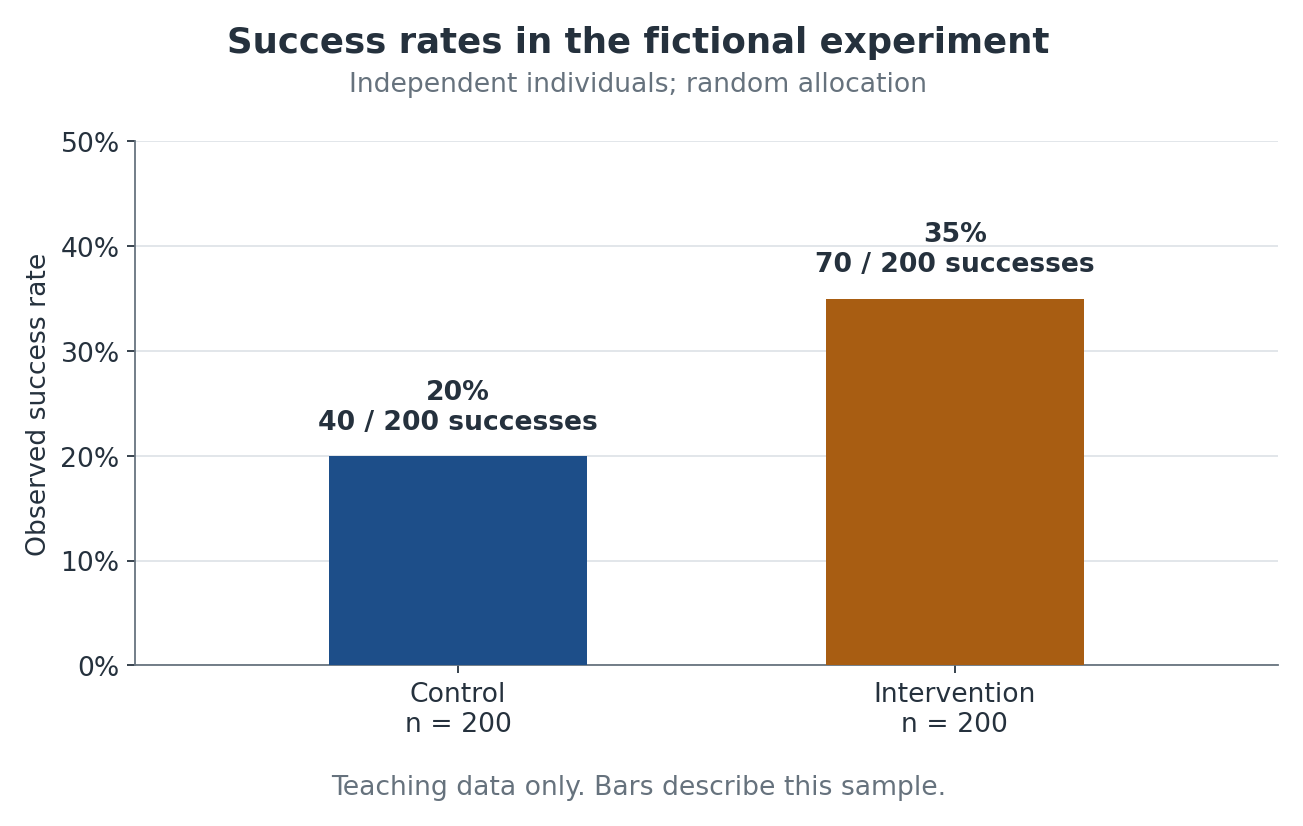
图中使用虚构教学数据:对照组 40/200=20%,干预组 70/200=35%,干预组比对照组增加 15 个百分点。纵轴从零开始,柱上的人数与比例共同交代比较的分母。
数值分布的直方图把取值范围分成相邻区间,柱表示落入各区间的观测。类别代码没有这种数值距离,因而与直方图的区间定义不同。区间等宽时,频数可直接比较;区间不等宽时,若让面积表示频数,柱高还要随宽度调整。箱线图则以位置与跨度概括数值分布,其中的离群点由特定规则标出,标记本身并不判断记录是否错误。
类别较多的饼图要求同时比较角度与面积,带有类别标签的条形图通常更易读。同一颜色表示同一组别,辅以文字或形状后,图中的组别关系也不依赖读者能否分辨颜色。
图形尺度与统计解释
条形图以长度编码数量,从零开始的轴使条长比例与数值比例一致。截去轴的低端,会放大较小的比例差;点图可以缩窄轴范围呈现细节,但其数值尺度仍由轴标签定义。没有统计含义的三维效果或不同条宽还会让面积与长度暗示不同关系,使读者难以辨认真正被比较的量。
一幅图的分母、测量单位、观察时期、对象范围和缺失口径,与表中的定义一样影响解释。例如,3/5 与 300/500 均为 60%,比例相等,观测数量却不同;仅画两根同高的柱,便隐藏了信息量的差别。人数与比例共同呈现这种结构,不确定性区间进一步表达抽样波动。
观察差异的大小可以从图中读取,统计推断却还涉及这些差异在重复抽样中的变化。误差条重叠与否无法单独决定正式比较的结果;人群选择或共同原因造成的混杂,也并不因图形清楚而消失。这些问题分别属于抽样推断与研究设计。
习题
- 在贯穿案例中, 与 分别回答什么问题?哪一个是对照组成功率?
- A 组 20 人中 10 人成功,B 组 80 人中 24 人成功。这 100 人的整体成功比例是多少?直接平均两组成功率会得到多少,为什么不同?
- 问卷允许多选,共 100 人,选择 A 的有 70 人、选择 B 的有 60 人。比例之和为 130% 一定是数据错误吗?
- 五个等待时间为 2、3、4、5、36 分钟。如果想描述典型等待和平均资源占用,你会如何报告,为什么?
习题解答
- 是所有成功者中对照组所占比例; 是对照组内部成功比例。对照组成功率使用第二个分母,因为它以接受对照的全部人为比较基准。
- 这 100 人的整体成功比例为 。组成功率分别为 50% 与 30%,简单平均为 40%。A 组人数较少,给两组相同权重会过度代表 A 组;整体比例应按人数加权。
- 不一定。一个人可以同时选择 A 和 B,选项不互斥;比例均以 100 位答题者为分母。应标注可多选,并核查每个选项是否每人最多计一次,而不是强行把两个比例缩放至总和 100%。
- 中位数 4 分钟更贴近居中的个体体验,均值 10 分钟对应每人平均资源占用;同时展示原始分布或注明长等待值,可以避免单一数字掩盖偏斜。不能因为 36 很大便直接删掉,需要先判断是否记录错误。
上一篇:02 数据类型与研究设计 · 下一篇:04 概率公理与计数 · 返回课程导航
相关概念:风险优势与效应量。