置信区间的覆盖率和检验的第一类错误,都是重复抽样中发生某个事件的概率。一份样本只能产生一次区间或一次拒绝决定,无法直接展示这些概率。保持总体参数不变、反复生成新样本,便能用频率近似研究统计程序的性质。
这种仿真近似依赖 大数定律与中心极限定理,自身也包含 Monte Carlo 误差。以下二项区间与 多重检验的数值例子,分别说明方法的实际表现与评价误差。仿真输出见 计算材料与数值结果中的 results/simulation.json。最后讨论敏感性分析:当生成机制无法完全确认时,当前结论如何随假设改变。
仿真模型与统计程序的评价
同一种区间规则,在不同样本量和总体参数下可能具有不同覆盖率。生成模型规定分布、依赖和参数,统计程序规定每份样本如何转化为估计、区间或拒绝决定。偏差、标准差、覆盖率、第一类错误和功效都是二者共同确定的性质。仿真重复次数只决定这些性质被估计得多精确。
例如评价一个 95% 区间方法,应重复生成 份样本,记录第 份区间 ,再计算覆盖比例:
在重复中固定,区间随新样本改变。95% 覆盖表达的是随机区间包含真值的频率。已经观察到的一个区间,要么包含真值,要么不包含;上述频率并未给固定参数增加一个后验概率。
方法的这种表现具有场景条件。独立、轻尾数据下的结果,不能自动推广到依赖、重尾、测量误差或选择偏差的情形。改变生成机制所对应的分布,才是在评价这些条件变化对方法的影响。
标准化样本均值的抽样分布
设 独立同分布于均值 1、方差 1 的指数分布。这个原始分布很偏斜,但标准化均值
随着 增加趋近标准正态分布。设 ,在每个样本量下分别重复抽样数千次,得到的 分布可以用均值、标准差和尾部概率与标准正态比较。每份样本内的原始变量仍服从偏斜的指数分布,趋近正态的是它们经标准化的平均值。
独立性使样本均值的标准差为 ,重复抽样所得样本均值分布的离散程度应近似这个值;标准化后的统计量则具有不同的尺度。这里标准化使用已知的总体标准差 1;改用样本标准差后,分母本身也随机变化,所研究的统计量随之改变。
收敛速度取决于原始分布,因此不存在一般的“30 就足够”界线。重尾可能使正态近似较慢,Cauchy 分布则没有有限均值和方差,不满足这条常用 CLT 的条件。观察相关还会改变均值方差,不能再机械采用 。例如,将同一个随机数复制 100 次,虽得到 100 个数,却没有 100 份独立信息。
这一 CLT 比较是扩展练习的实验设想,尚未给出数值结果。随教程的 simulate.py 计算的是下文区间覆盖和多重检验的实验,二者的已执行结果不应与这个设想混同。
二项区间的名义水平与实际覆盖率
对二项样本 ,Wald 区间使用
在小样本且概率接近边界时,样本中没有成功的情形可能并不罕见。若 ,这一事件的概率为 。对应样本具有 和零估计标准误,Wald 区间因而退化为 ,必然遗漏真实的 0.05。仅这一类样本已将覆盖率限制在约 以下,说明欠覆盖可以从区间构造本身预见。
Wald 用样本比例估计标准误,边界附近的估计标准误可能严重失真。Wilson 通过反演 score 检验构造,零次成功时仍有非零宽度,通常更稳定。不过,二项分布的离散性使覆盖率随 起伏,它也没有每个参数点至少达到 95% 的保证。
固定种子 20261012、每个场景重复 20,000 次,得到下面的覆盖比例;同时枚举全部二项计数,计算同一区间规则的实际覆盖概率。
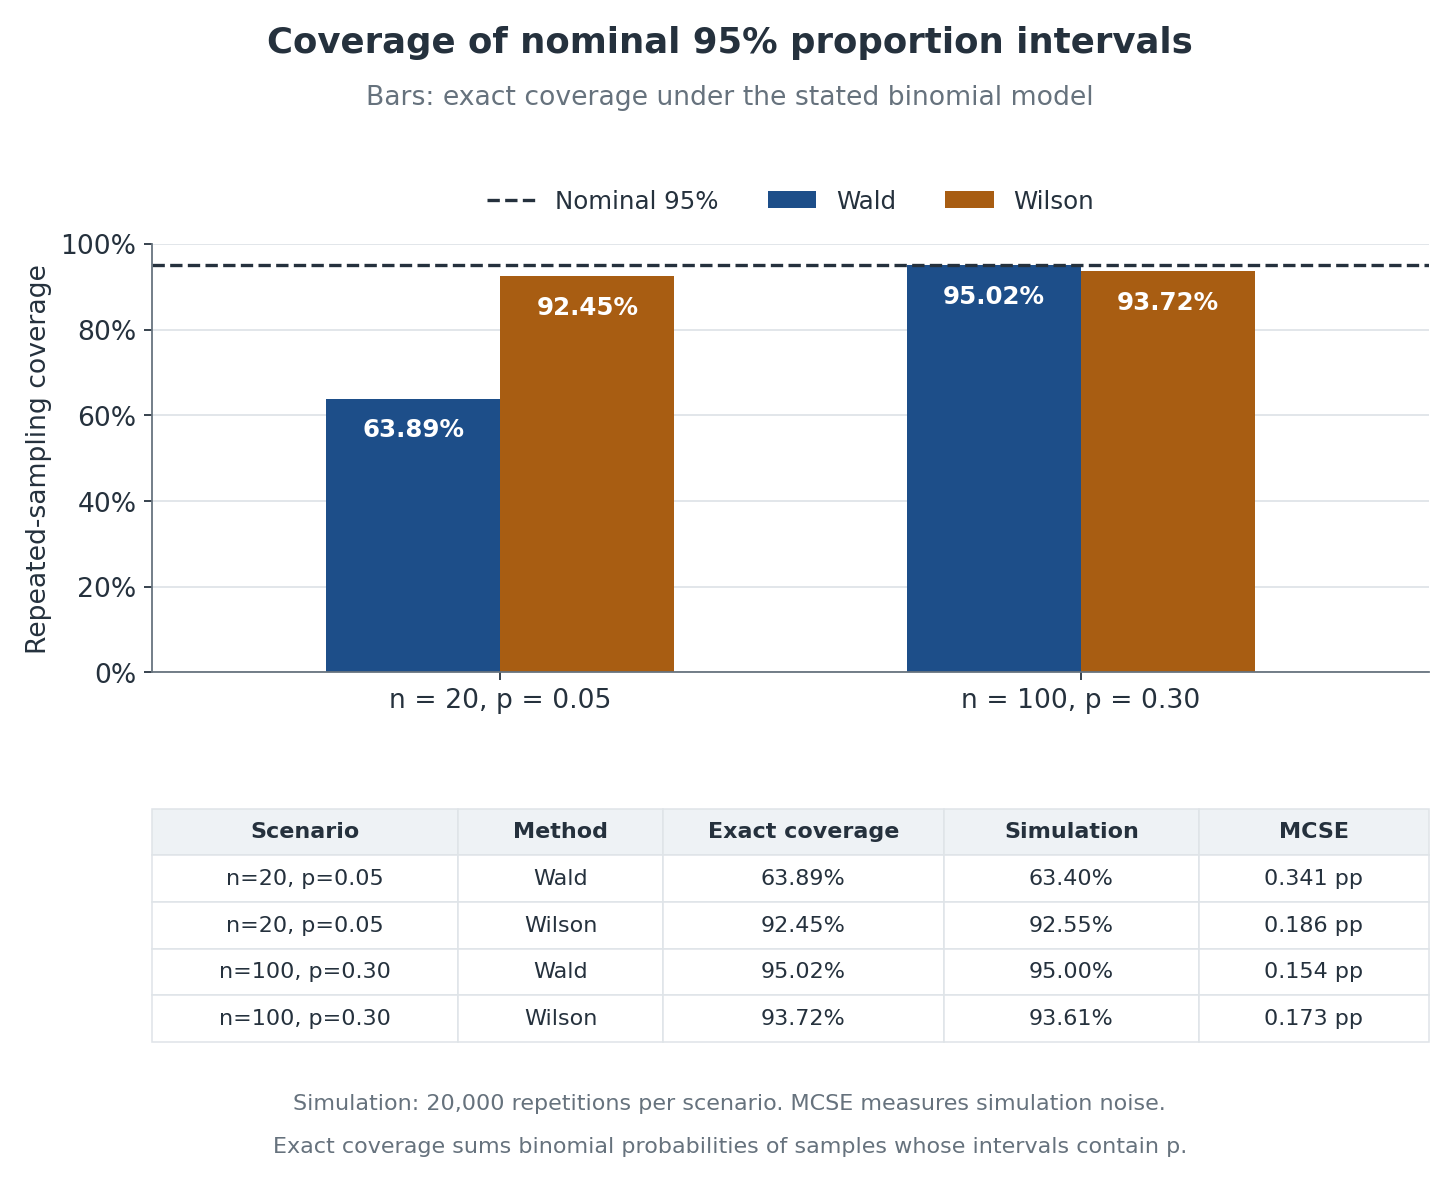
图中柱形表示二项枚举得到的实际覆盖率,虚线标出名义水平 0.95。下表列出两万次仿真的覆盖比例、Monte Carlo 标准误(MCSE)及枚举结果。Wilson 的实际覆盖率并不保证在每个参数点达到名义水平。
| 样本量与真值 | 方法 | 仿真覆盖率 | 枚举所有二项计数得到的覆盖率 | 仿真 MCSE(百分点) |
|---|---|---|---|---|
| Wald | 63.40% | 63.894% | 0.341 | |
| Wilson | 92.55% | 92.452% | 0.186 | |
| Wald | 95.00% | 95.018% | 0.154 | |
| Wilson | 93.61% | 93.719% | 0.173 |
枚举覆盖率一列计算
每种计数对应一个确定区间,把其中覆盖真值的计数概率相加,就得到该参数点的覆盖概率。这项有限求和没有 Monte Carlo 抽样误差,但没有改变原区间规则:被评价的仍是 Wald 与 Wilson。“覆盖概率的精确计算”与“精确置信区间”具有不同含义。
第二个场景的 Wald 覆盖率比 Wilson 更接近 95%,而第一个场景的 Wald 严重欠覆盖。方法的单点优劣由此不能直接概括为整体优劣;评价还涉及参数范围、区间长度等性质。Clopper–Pearson 二项区间通常较保守,可以满足至少名义覆盖的要求,但往往更宽。
Monte Carlo 标准误
每次“是否覆盖”是一次 Bernoulli 事件。若重复彼此独立,仿真比例的 Monte Carlo 标准误可估为
当覆盖约 95%、 时,MCSE 约为 0.00154,即 0.154 个百分点。94.9% 与 95.0% 的差异还小于这一误差尺度。本章 的 Wald 覆盖估计 MCSE 为 0.00341,约 0.341 个百分点,因而仿真比例与无抽样误差的枚举概率可能有可见差别。
重复次数与单次样本量作用于不同层次。增大重复次数提高的是仿真评价的精度;改变单次样本量则改变统计程序所面对的抽样条件。将 从 1,000 提高到 100,000,可以更准确地估计小样本 Wald 区间的欠覆盖程度,但不会改变该区间规则的实际覆盖概率。
两种区间若作用于同一份模拟样本,其覆盖事件就成了配对观察。共同抽样可能减少方法差异的随机波动,而“两种覆盖率之差”的标准误也应包含这种相关。各自覆盖率的 MCSE 与差值的 MCSE 并不是同一个量。
多重检验的家族错误率
为了单独考察多重检验,脚本生成 20 个相互独立、服从 Uniform(0,1) 的零假设 值。这对应所有零假设都真、检验连续且校准正确的理想情况。真实检验可能离散、相关或模型不成立,其 值未必符合这里的独立均匀假设。
若每项都按 0.05 拒绝,至少一次错误拒绝的概率为
家族错误率(FWER)考察整组检验中是否出现至少一次误报。20 项检验各自的第一类错误率都为 5%,这组检验的 FWER 仍远大于 5%。
Bonferroni 把各项阈值改为 。由并集概率上界,即使检验相关,只要各项零假设 值有效,FWER 也不超过 0.05。在独立均匀场景下,其实际理论 FWER 是 。
| 策略 | 20,000 次仿真的 FWER | 此独立场景的理论 FWER |
|---|---|---|
| 各项阈值 0.05 | 64.365% | 64.151% |
| Bonferroni 阈值 0.0025 | 5.245% | 4.883% |
Bonferroni 的仿真 MCSE 约为 0.158 个百分点,估计值比理论值高约 2.3 个 MCSE。理论上界约束的是真实 FWER,有限仿真比例则是带误差的估计,所以可能超过 5%。若不断换种子,直到结果低于 5%,留下的估计就经过了选择,无法如实表现原仿真程序的波动。
Holm 与 Bonferroni 都以 FWER 为目标,Holm 通常不比简单 Bonferroni 更差。BH 主要控制错误发现率(FDR),其目标及独立性或依赖条件有所不同。将这些控制都称为“错误概率为 5%”,会掩盖分母与错误事件的区别,详见 多重比较。
第一类错误与功效的仿真评价
两组总体成功率相同时,检验仍可能因抽样波动拒绝无差异假设,这种概率就是第一类错误。在该零假设下重复生成两个独立二项样本,并使用相同检验,所得拒绝比例估计的就是第一类错误率。
功效是在某个具体备择为真时拒绝的概率。比如设对照成功率 0.20、干预成功率 0.35,每组 200 人,再重复执行相同检验。功效由这个效应、样本量、检验和阈值共同决定,单次结果是否显著并不能反推出它有多高。
样本量、基线风险、真实效应和失访程度各自改变功效。因此,功效比较通常涉及一个场景网格,而不是一个孤立数值,每个仿真比例还带有 MCSE。只有在第一类错误受到适当控制的条件下,较高功效才具有可比含义;误报率偏高也会使拒绝比例虚高。
模型假设与结论敏感性
当前资料往往无法识别所有生成因素。对于缺失机制,可以赋予未知部分一系列有依据的参数,考察效应何时改变方向或大小。这是敏感性分析所问的假设依赖;仿真则在指定真相下考察程序性质。二者可以结合,但所得结果分别属于这两个解释层次。
在 上一章的模拟研究 中,年龄的线性 logit 关系是真实机制的一部分。若不知道它,可以考察合理非线性形式或有限的替代变量表达。但模型之间的比较须保持目标量一致:条件 OR 与标准化风险差针对不同问题,数值不同本身不是不稳健的证据。
原始模拟没有缺失。一个扩展实验是:保留完整资料,在副本中按指定机制制造缺失,再比较完整案例、MAR 多重插补和 MNAR 偏移场景。此时缺失是实验新增的机制,不能被解释为原始研究已经具有的特征。
未测混杂、结果误分类、异常对象和观察窗口也可以形成敏感性场景。各场景的意义来自具体机制,结论则应由整组结果共同支持。只选显著的规格,会遗漏分析本来旨在揭示的假设依赖。
随机数状态与数值复现
随机种子确定生成器的初始状态,后续序列还取决于生成器类型、抽样顺序、调用次数及相关依赖版本。数值库或并行计算也可能产生额外差异。因此,在序列前部增加一次随机抽样可能改变后续结果,即使种子保持不变。完整的数值复现需要同时说明这些计算条件。
seed、依赖、脚本、输入数据和输出确定了一个可复核的数值实例,文件哈希还可以区分不同输入版本。一个固定种子能重建实例,却不能说明仿真估计已足够稳定;这种稳定性来自重复次数、Monte Carlo 误差及预先规定的多种子比较。事后挑选种子改变的则是被呈现结果的选择机制。
习题
- 做 10,000 次区间仿真得到覆盖率 0.90,MCSE 大约是多少?把重复次数翻四倍会发生什么?
- 小样本 Wald 区间有时变成 。增加仿真次数能解决这个问题吗?
- 20 次独立检验各自显著性水平 0.05,为什么家族错误率不是 ?
- 固定种子但插入一次新的随机抽样后,后续结果改变。是否说明随机数生成器坏了?
- Wilson 在一个场景的覆盖比 Wald 更低,是否应永久放弃 Wilson?
参考解答与推理
- ,即 0.3 个百分点。重复次数翻四倍使 MCSE 约减半,但不会改变方法真实覆盖率。
- 不能。退化来自区间规则对零成功样本的处理。更多重复只是更准确地看见缺陷;改用合适区间方法或改变真实研究样本设计才影响其表现。
- 是并集概率的上界,不是一般的精确值;各项误报事件有重叠。独立时用“没有任何误报”的补事件,得到 。
- 不是。生成器有状态,新调用消耗了部分序列。要严格复现需保留生成顺序,或为不同实验管理明确的独立随机数流。
- 不应只看单点。需要查看合理参数网格的覆盖、长度和稳定性。本章恰好展示单点排序可能变化,因此方法建议应建立在更广的证据上。
上一篇:28 二分类研究的综合分析 · 下一篇:30 分类数据分析的综合习题 · 课程总览