两组成功比例之间的优势比,可以推广为多个协变量给定后的条件比较。Logistic 回归以成功概率的对数优势为均值变换,用解释变量的线性组合描述这个量;逆变换则把拟合值送回概率范围。系数因此具有优势尺度上的含义,概率差却仍随基线水平变化。
参数估计来自 Bernoulli 结果的联合似然。只含二元组别时,两组比例可以分别拟合;共享多个协变量系数时,各观测的概率受到共同结构约束。这个约束既提供了调整和交互的表示,也决定哪些数据结构能够支持有限且稳定的估计。
似然把概率模型变成参数估计,OR 与风险区分优势与风险尺度;GLM 三要素给出这里使用的 Bernoulli 分布、预测子与链接结构。
Bernoulli 条件模型
以 表示成功、 表示未成功,以包含截距的 表示解释变量。标准模型以给定协变量后的独立 Bernoulli 结果为随机部分,并规定 logit 与共同参数的关系:
将对数优势关系反解,条件成功概率为
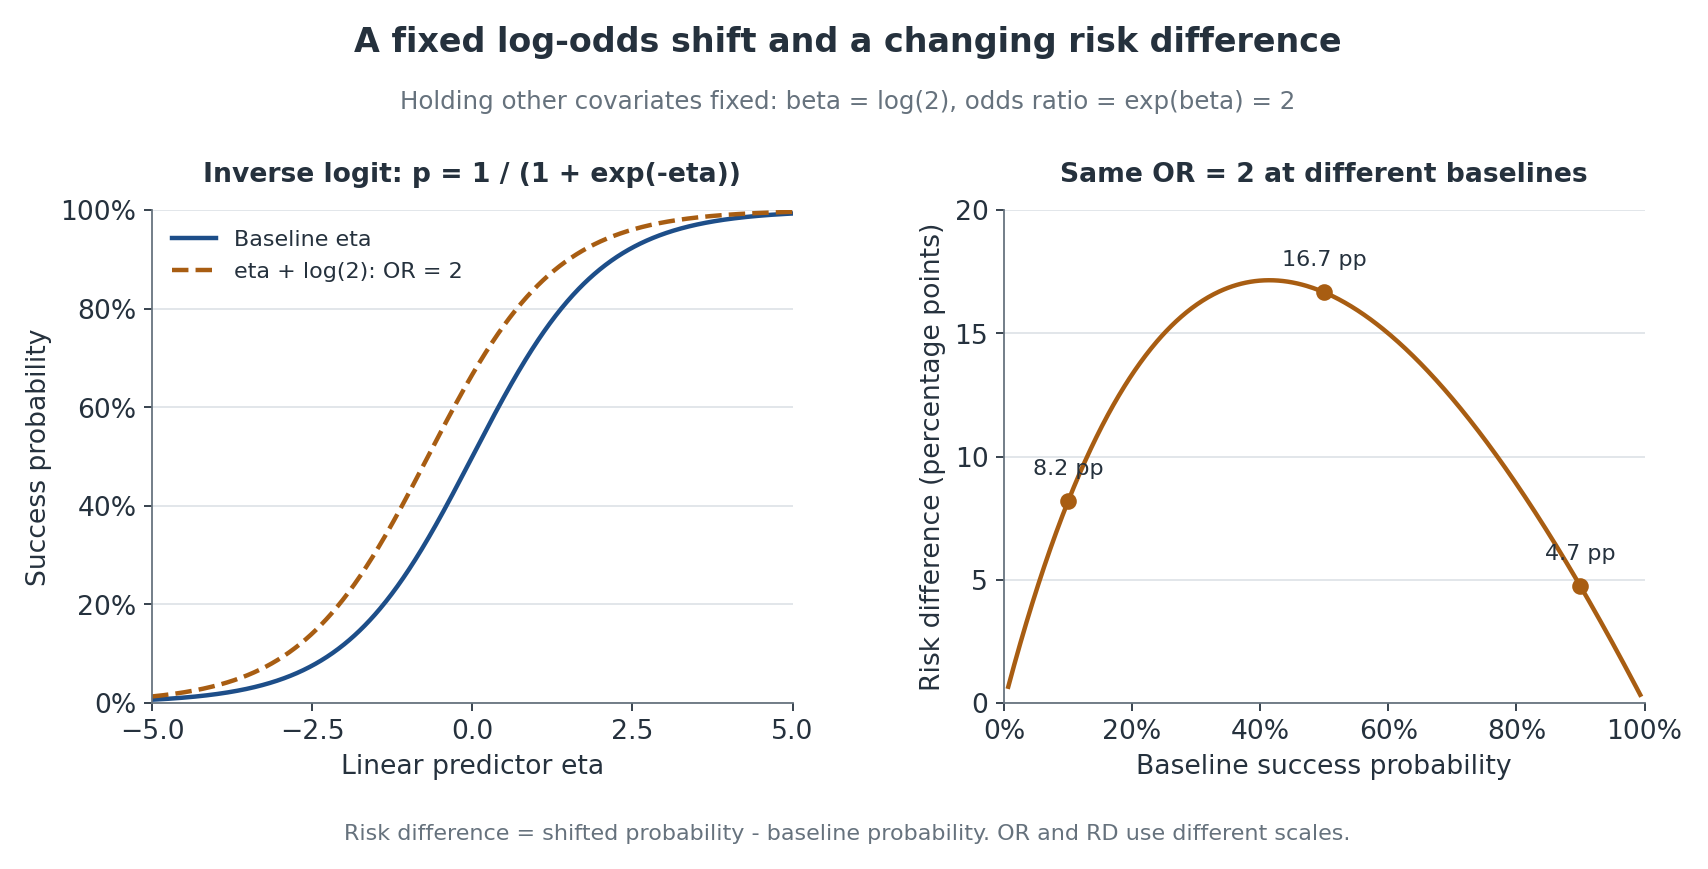
图的横轴是线性预测子 η,纵轴是成功概率 p。曲线在不同位置有不同陡度,相等的 η 增量由此对应不同的概率增量。这说明恒定 OR 可以与变化的风险差同时成立,也说明概率尺度上的效应取决于起点。
结果编码决定事件方向。若以未成功为 1,模型描述未成功优势,系数符号相应反转,OR 取倒数。参考组规定比较的起点:干预编码为 、对照为 时,组别系数表达干预相对于对照的 logit 差。
系数与条件优势比
设变量 只以一次项进入预测子,没有相关交互项。固定其余协变量, 增加一单位使 logit 增加 ,即成功优势乘以 。两种条件优势的比值因此为
指数系数 是给定其他协变量后的条件 OR,也称调整 OR。对二元 ,比较的是 与 ;年龄以年计量时,它对应相差一岁的优势比较。相差十岁时,logit 差累加,OR 为 ;乘积尺度上的累积与直接把 OR 乘以十不同。
把 OR 转回概率,还需要基线风险。例如 ,另一组优势为其 2 倍时,概率满足
得到的概率小于直接乘出的 。基线若为 ,相同 OR 为 2 则给出 。这两个例子说明 OR 与风险差描述不同尺度:由条件 OR 转到实际概率,代表性个体的预测或共同人群的标准化风险提供了所需基线。
两组模型的参数估计
在虚构的独立个体随机分配实验中,对照 200 人有 40 人成功,干预 200 人有 70 人成功。仅用组别表示成功概率:
截距与组别系数提供两个自由参数,能够分别表示两组的内部概率。极大似然取 、,于是
组别系数指数化为 。干预预测子的值为 ,逆链接返回 0.35。系数差约为 0.767,量纲是 logit;把它当作概率增加 76.7 个百分点会混同尺度,样本风险差实际为 15 个百分点。
两组独立,使两个样本 logit 的渐近方差可以相加。各格人数足够大时,代入成功和未成功频数,斜率的常规大样本标准误为
Wald 95% 区间在 logit 差尺度上取 ,指数变换后给出 OR 区间 。它与四格交叉乘积 OR 的常规对数区间一致。近似依据是对数尺度上估计量接近正态;稀疏、分离或强非对称似然会破坏这种局部对称结构,轮廓似然、适当惩罚及其他方法则从不同角度描述参数不确定性。
Wald 检验使用估计值与标准误,似然比检验使用两个模型的最大似然差,score 检验使用原假设处的变化信息。它们在常规大样本中相互接近,有限样本的 值可以不同。分析计划指定的检验具有相应错误率;事后只取最显著者,已经改用了由数据筛选的另一种规则。
似然与得分方程
单个观测的条件概率可统一写为 。给定协变量后的观测独立时,联合概率相乘,其对数成为可相加的各个体贡献:
极大似然把参数作为未知量,寻找与已观察结果最相容的联合概率。当成功观测对应的预测 很小时, 的贡献很负;未成功观测对应的概率接近 1 时, 也很负。这些项使似然同时利用两种结果的信息,约束模型的过度确定预测。
一组内共享概率 ,且有 个成功、总数为 时,对数似然除去不含参数的组合常数为 。在内部最大值处,对 的导数为零:
两个组概率互不约束时,导数方程分别给出各组样本比例。一般回归则以同一组系数联结不同观测,得分方程为 。它要求结果与拟合概率的差,沿各解释变量方向加权后相抵。Newton 或迭代加权最小二乘利用似然局部曲率数值求解,解所表达的条件关系由结果编码、设计矩阵及观测假设共同决定。
嵌套模型的改进程度可由似然比统计量 表示,在常规条件下,其卡方自由度为增加的参数数目。两个似然须针对同一个结果、同一批观测,才能把差异归于新增参数;若缺失处理使样本不同,差异同时包含数据改变,就不再具有这项比较意义。
协变量调整与标准化
年龄、基线访问量和渠道可以共同表达个体的成功概率。例如,教学模拟资料的模型写作下式,完整数据与计算见二分类研究的综合分析:
search 为参考渠道, 为类别指示,baseline_visits 为干预前测量。在没有干预交互项的模型中, 比较年龄、基线访问量和渠道相同的人之间的成功优势。其他变量改变基线 logit,所以同一个条件 OR 仍可对应不同概率差。遗漏混杂、函数形式错误和选择偏差各自影响条件比较,协变量调整本身没有把它们一并消去。
条件 OR 与未经调整的边际 OR 也可能由于OR 非可塌缩性不同。人群平均风险差以共同的协变量分布为对象:对同一个目标人群分别置 和 ,逐人计算概率,再分别平均并作差。平均概率保留了目标人群权重;先平均 logit 再逆变换则交换了非线性运算,通常得到另一结果。把这样的标准化解释为因果效应,还依赖相应识别条件和设计。
观察性模型的调整 OR 表达给定协变量后的关联。随机分配为因果比较提供设计基础,实际执行偏离、失访和干预后变量调整却可能改变观察到的人群或效应。因果解释因而同时取决于目标效应的定义、分配过程和观察过程,而非只取决于回归方程。
交互作用及其尺度
干预的 logit 效应随年龄变化时,乘积项提供了一个直接表示:
固定年龄为 ,从两组预测子相减可得干预 OR
由于年龄在中心化原点为零, 表达 40 岁的干预 log OR。设 、,40 岁的 OR 约为 2.014,50 岁为 。主效应与乘积项通常一起保留,才能分别表达参考年龄的组间差异和差异随年龄的变化。交互的设定来自研究问题;大量事后筛选会把原先的单项检验变成一组数据依赖比较,并改变通常错误率。
这项交互定义在 logit/OR 尺度上。即使 ,逆链接的弯曲仍会使风险差随年龄和基线概率改变。因此,无交互也必须附着于具体尺度;预测概率曲线及其不确定性可以进一步表达概率尺度上的变化。
分离与估计稳定性
当一个变量组合完全区分成功与未成功时,参数可以沿某方向增大,同时不断提高观察结果的拟合概率,这称为完全分离。若边界存在重合而某些方向仍可无限改善似然,则为准完全分离。例如,对照全未成功、干预全成功时,截距与斜率可使拟合概率逼近 0 和 1,似然不断接近极限,却不能在有限系数处达到最大值。一个组全未成功、另一组含两类结果,也形成准完全分离。
分离数据把参数约束成单侧方向,缺少阻止系数继续增大的相反证据。巨大系数和标准误、接近 0 或 1 的拟合概率及不收敛,都是这种结构的数值表现;继续迭代或一次收敛提示不会创造缺失的信息。更合理的模型或补充数据可能改变结构,Firth 惩罚或合理先验则改变估计准则。相应有限结果须按其准则解释,并考察对稀疏信息的敏感程度。
同一人重复出现,或医院、班级内结果相关时,独立似然的普通标准误没有包含相应协方差。聚类稳健估计、GEE 和混合模型分别以不同方式表达联合波动,各有适用条件。少量事件同时支撑很多参数,也可能留下很平坦的似然方向,使估计过拟合、区间较宽;固定的“每参数事件数”无法概括类别分布、效应规模和设计矩阵共同决定的信息量。
估计对象与似然信息
Logistic 模型共享线性预测子中的参数,又通过逆链接保留个体基线风险。系数表达条件 log OR,标准化概率表达目标人群的平均风险;交互尺度与非可塌缩性说明这两个层次为何不能直接混同。
最大似然把 Bernoulli 观测的信息汇为共同参数,有限解、局部曲率、函数形式和观测独立性决定其常规推断依据。参数解释与新样本预测仍是不同问题,后者还涉及排序、校准与阈值代价。相关模型理论见 参考教材与开放课程。
习题
- 年龄系数为 0.03,其他变量固定,十岁差对应的 OR 是多少?可否解释为成功概率增加 30%?
- 为什么贯穿案例仅含干预指示时,Logistic 与列联表 OR 完全一致?
- 含交互模型中年龄以 40 岁中心化,、。60 岁的干预 OR 为多少?
- 模型一个类别全失败,拟合出现巨大负系数。是否只要增加迭代次数?
参考解答
- 。这是优势约乘以 1.35,概率变化还取决于基线概率,不能直接当成概率增加 30%。
- 两个参数分别允许两组取得独立的拟合概率,极大似然取组内成功比例。两组 logit 之差指数化,正好得到交叉乘积 OR。
- 。干预主系数只对应中心化值为零的 40 岁,不能直接用于 60 岁。
- 不是。先排查分离及稀疏信息;若有限 MLE 不存在,增加迭代只让系数走得更远。应采用适当方法并报告其假设和不确定性。
上一篇:22 从线性模型到广义线性模型 · 下一篇:24 模型诊断与预测评估 · 课程总览